
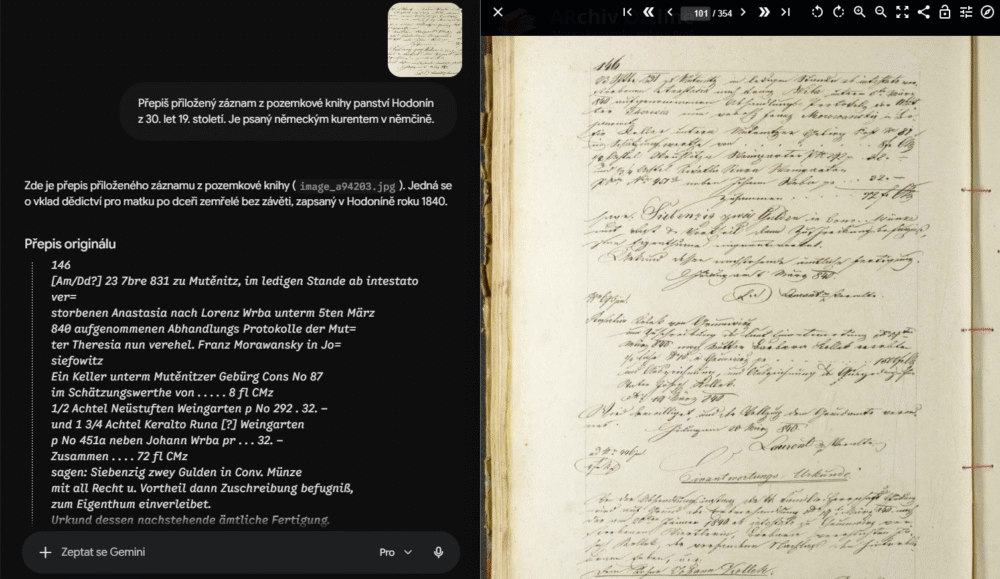
V prvním díle našeho seriálu o AI a genealogii jsme si blíže popsali, jak vám umělá inteligence může pomoci radami při sestavování rodokmenu a hledání předků. Dnes na tyto informace a navážeme a podíváme se na to, jestli a jak je možné AI využít při čtení archivních záznamů.
Pokud čekáte rychlou odpověď, pak ano, umělá inteligence se může stát při čtení starých zápisů vydatným pomocníkem. Tak ale jako u veškerých dalších výstupů, které vám poskytne, je potřeba vše kontrolovat, opravovat ji a případně s ní o poskytnutých výsledcích dále debatovat.
Jaký nástroj nebo AI službu vybrat?
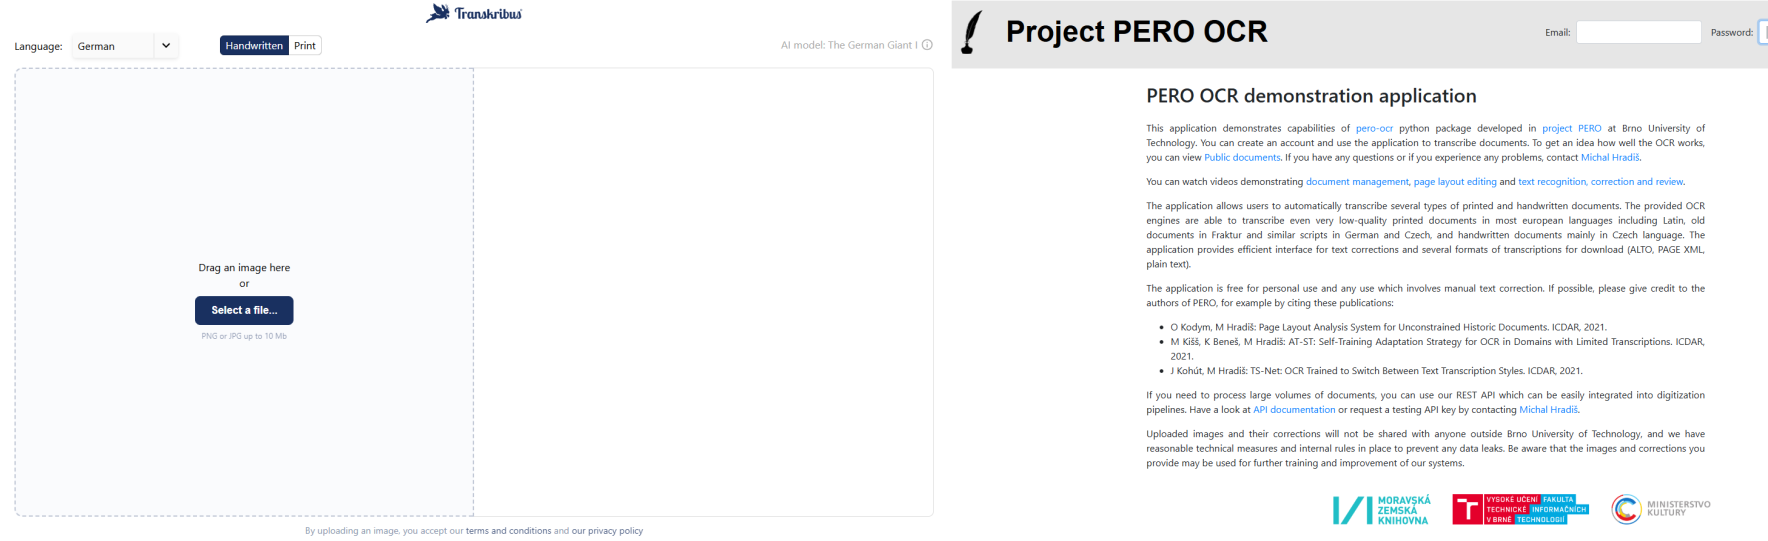
Pokud chceme transkripci textů provádět s pomocí AI, více než kde jinde v tomto případě platí, že je potřeba zvolit správný nástroj. Existují služby, které se vysloveně specializují na čtení ručně psaných textů. Patří mezi ně především zahraniční Transkribus nebo české Pero, o kterých jsme podrobněji psali už dříve.
Doba však pokročila a dnes už si se čtením starých dokumentů velmi dobře poradí i některé jazykové modely. Ty mají navíc oproti výše zmíněným nástrojům jednu obrovskou výhodu. Zatímco nástroje jako Transkribus jsou natrénované na tisících stran starých textů pouze na jejich přečtení, jazykové modely nad nimi dokáží přemýšlet, spoustu věcí si dovodit na základě kontextu, a proto dávají dobré výsledky. Blíže si to v textu ještě popíšeme.
Z našich zkušeností (stav k září 2026) bychom spíše než ChatGPT nebo Claude pro tento druh práce doporučovali využít LLM Gemini od Google. Ostatně je na něm postavený i nástroj Scribe AI od MyHeritage, který je určen právě pro přepisy naskenovaných dokumentů.
Stejně jako v každém jiném případě i zde platí, že si musíte dávat pozor na to, který konkrétní model jazykového modelu použijete. U Gemini je lepší využívat model Pro, případně Flash, než Flash-Lite (opět se jedná o stav v září 2026).
Jak překlady zadávat a s AI pracovat?
Jak jsme už nastínili, kontext je při zadávání archivních dokumentů k přečtení AI základ. Při psaní promptu proto uveďte nejen to, že potřebujete text přepsat, ale poskytněte umělé inteligence více dalších podrobností. Uveďte jestli se jedná o zápis z matriky, pozemkové knihy nebo z jiného typu dokumentu. Připojte informace o tom, kdy a kde byl napsán a jakým jazykem. Určitě jí pomůže i to, když zmíníte jména osob a názvy míst, které by se v textu mohly vyskytovat.
Jakým způsobem AI text poskytnout? Pokud se jedná o dokument, který je dostupný online, neposílejte jí na něj odkaz. S největší pravděpodobností se tímto způsobem k archiválii nedostane. Snímek buďto stáhněte, nebo udělejte printscreen. Ten pak k promptu přiložte.
Vložit můžete klidně celou stranu (s vyznačením, který text potřebujete přeložit). Umělá inteligence se tak ve všem lépe zorientuje. Stejně tak můžete, ale nemusíte delší zápisy na několik stran (typicky v pozemkových knihách) rozdělit na menší části a ty zadávat k přečtení průběžně. Gemini má ale už celkem rozsáhlé kontextové okno, takže by nemusela mít problém si poradit i s rozsáhlejšími texty naráz – tedy pokud se nebude jednat o desítky stran nebo celou knihu.
Pokud máte v textu problém s jedním konkrétním slovem, které nemůžete vyluštit, můžete to zkusit také s pomocí AI. Pro lepší kontext slovo v printscreenu vyznačte, pošlete obrázek s větší částí textu a připište co nejvíce informací, jak jsme si popsali už výše. Pro ještě lepší výsledek přepište do promptu tu část textu, kterou bez problémů přečtete, a vyznačte slova, která jsou vám nejasná. Umělá inteligence vám tak může pomoci například s určením místa původu nebo povolání, jehož významem si nejste zcela jistí.

Na co si dát při transkripcích pozor?
I zde platí, že si AI ráda vymýšlí. Pokud si není čtením nějakého slova jistá, může použít slovo jiné, které ji na dané místo přijde jako nejlogičtější nebo nejpravděpodobnější. Jestli ji k tomu výslovně nevyzvete, sama nepřizná, že něco neví nebo přečíst nedokáže. Vše je tedy potřeba kontrolovat.
Nejméně jistá si je AI při čtení osobních jmen a názvů míst. Pomoci v tom může dodání kontextu, jak jsme zmínili už dříve. Pokud ani to nepomůže a nástroj bude ve jménech dělat chyby, po kontrole části textu ho na to upozorněte. Velmi pravděpodobně to pomůže a v dalších fázích umělá inteligence už použije správná jména a názvy.
Na závěr je třeba zdůraznit ještě jednu důležitou věc. Můžeme předpokládat, že jazykové modely včetně Gemini velmi pravděpodobně neměly dostatek česky ručně psaných historických textů, aby se na nich mohly čtení dostatečně naučit. Pomůžou vám tak především při transkripcích textů psaných německy nebo třeba latinsky. Výsledky u českých textů jsou mnohem horší a je potřeba s tím počítat. Se starými matrikami či gruntovními knihami v češtině si modely ještě dost dobře neporadí. Využít je ale můžete při přepisování novějších ručně psaných textů, například deníků nebo dopisů, jejichž obsah byste pro příští generace rádi uchovali i v digitální podobě.